AICC2026大会聚焦算力变革 推动AI全栈协同与开放生态建设
多轮推理、长上下文、工具调用和多智能体协作,使计算瓶颈从单一算力环节进一步延伸至存储、互连、调度和软件栈,推动AI计算从单点优化走向面向真实负载的全栈协同。
新华财经北京9月22日电(记者孙广见) 2026人工智能计算大会(AICC2026)21日在北京举行。大会聚焦大模型、智能体加速演进带来的计算产业变革,以应用负载为牵引,汇聚芯片、系统、软件、模型与应用等产业链力量,展示前沿技术探索与落地实践,以开放、多元推动协同创新,共同探索适合智能体时代中国AI计算产业的发展路径,加快人工智能向现实生产力转化。
智能体加速产业与技术双重变革
工业和信息化部电子信息司电子系统处处长金磊表示,随着智能体加快进入生产、科研和社会服务,人工智能对计算能力提出更大规模、更高效率和更多元化需求。未来产业发展需要持续强化基础创新,推动计算架构、数据存储、高速互联、软硬协同和算电协同等关键技术突破;加强算力、存力、运力、电力等要素协同;完善标准体系、测试验证和服务平台建设,提升AI计算产业整体发展能力。
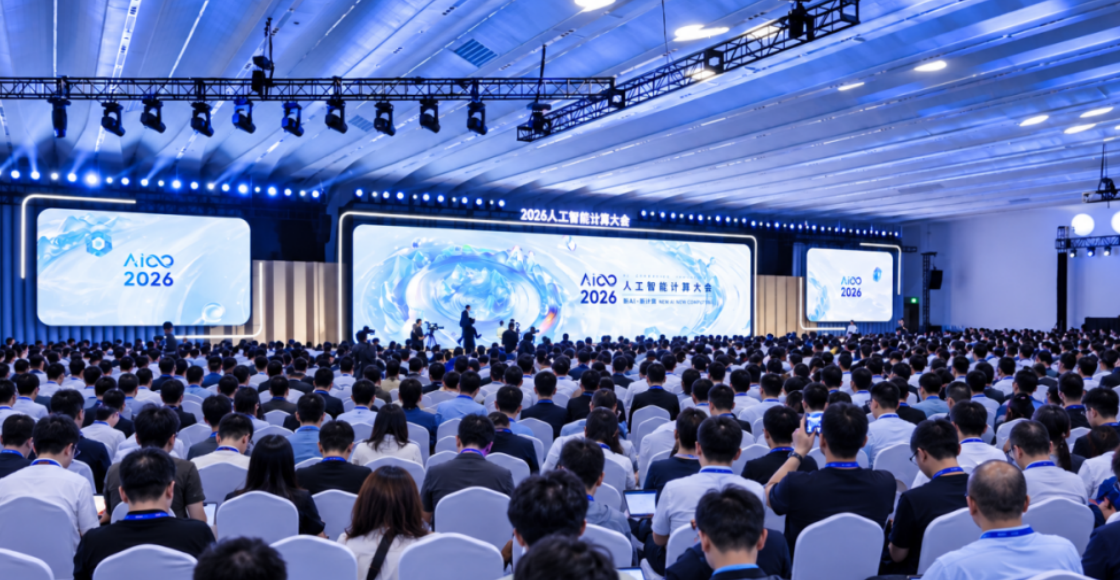 图为2026人工智能计算大会(AICC2026)现场
同济大学党委书记郑庆华围绕更高阶机器智能的演进路径展开分享。他认为,大模型依靠数据和算力驱动取得了显著突破,但面向更高阶智能,仅靠规模扩展仍面临持续学习、抽象推理和未知环境适应等挑战。未来机器智能需要进一步形成可持续、可泛化、可迁移的学习能力,并借鉴人脑记忆、联想等机制,探索面向小样本强推理的机器记忆智能新路径。
清华大学教授吴华强从存算一体切入,探讨AI算力芯片突破传统技术路径的可能性。他强调,面对大模型算力需求快速增长以及传统芯片在面积、带宽等方面的约束,AI算力芯片创新不能只依赖既有技术路径,还需要从新器件、新架构和新计算范式中寻找突破。忆阻器存算一体通过重构计算与存储的关系,减少数据搬移,并通过器件、工艺、电路、架构与软件协同,为高算力芯片发展探索新的技术路径。
应用负载牵引全栈协同 开放生态释放多元算力
Agent的快速普及正在重塑基础设施。多轮推理、长上下文、工具调用和多智能体协作,使计算瓶颈从单一算力环节进一步延伸至存储、互连、调度和软件栈,推动AI计算从单点优化走向面向真实负载的全栈协同。
围绕这一变化,浪潮信息首席AI战略官刘军将Agent时代的AI计算概括为两个演进方向:能力型智算,支撑突破智能上限;容量型智算,实现智能充分供给。面向这两类需求,计算系统需要以大模型和Agent负载为牵引,统筹算子、内存、互连与整机系统,从局部优化走向端到端协同。
北极雄芯创始人、首席科学家马恺声认为,Chiplet的价值不只是突破单芯片集成边界,更在于面向工作负载重新组织计算、存储和互连资源,系统瓶颈正在从单纯算力扩展到带宽、访存和通信等环节,架构设计需要根据模型特征、并发需求和时延成本目标进行选择,通过3D集成、近存计算等路径提升整体计算效率。
北京智源人工智能研究院副院长兼总工程师林咏华指出,AI负载不会收敛,计算架构也不会只剩一种。硬件创新要转化为可用算力,需要共享的软件生态支撑。众智FlagOS通过统一编译器、算子、通信和训推框架等能力,降低多元芯片的重复适配成本,让不同计算架构更快进入AI生态。
SGLang核心贡献者张晓雨表示,Agent时代的推理优化正在从单点算子加速走向系统协同。SGLang通过统一Kernel接口衔接不同硬件与实现路径,并将Kernel与调度、缓存、模型执行共同设计和验证,提升多元硬件环境下的推理效率;同时引入Agent参与算子生成、调优和验证,加快底层优化迭代。
会上,国际数据公司(IDC)与浪潮信息联合发布《2026年中国人工智能计算力发展评估报告》。《报告》围绕智能体规模化带来的算力变革,从算力供需、基础设施演进和产业发展趋势展开分析,指出智能体正在重塑AI算力基础设施,以乘数效应推动Token(词元)消耗激增,带动中国智能算力规模斜率大幅上调。预计2026年中国智能算力规模将达到2576.5 EFLOPS,同比增长87.9%。
据了解,今年是AICC人工智能计算大会的第七届。本届大会由中国人工智能学会支持,北京开源芯片研究院、北京智源人工智能研究院、清华大学具身智能与机器人研究院、中电标协开放计算标准工作委员会OCTC、SGLang、Datawhale、CSDN等多家专业机构及开源社区联合主办。
编辑:罗浩
声明:新华财经(中国金融信息网)为新华社承建的国家金融信息平台。任何情况下,本平台所发布的信息均不构成投资建议。如有问题,请联系客服:400-6123115