
未来智造局丨从“显卡”到系统级芯片平台 格兰菲把国产GPU推向端侧市场
格兰菲做端侧AI是二十余年GPU底层架构迭代的自然延伸。GF800所面向的端侧和边缘场景,正成为人工智能从云端向终端延伸的重要方向。
新华财经上海10月16日电(记者高少华)端侧AI正快速从技术概念走向规模化应用,背后是大模型轻量化与终端芯片算力提升的双轮驱动。在第26届中国国际工业博览会上,国产图形处理器(GPU)厂商格兰菲智能科技股份有限公司(简称“格兰菲”)展出的主打产品,是一款刚完成芯片调试、已向终端客户送样的高性能安谋(Arm)架构系统级芯片GF800及其板卡。展台的主角,从显卡变成了一颗完整的系统级芯片。
格兰菲副总经理武文杰和首席策略官王渊峰在接受记者专访时表示,公司做端侧AI并非在AI热潮中转行,而是二十余年GPU底层架构迭代的自然延伸:从图形渲染出发,进入通用计算,再延伸到端侧AI处理器和系统级芯片平台。GF800所面向的端侧和边缘场景,正成为人工智能从云端向终端延伸的重要方向。
不做AI的“转行者” 二十年架构迭代撑起技术主线
格兰菲是一家总部位于上海的国产GPU厂商,成立以来长期专注图形处理器/通用图形处理器(GPGPU)设计,产品覆盖图形渲染、通用计算、人工智能、视频编解码与显示等场景。依托核心团队二十余年技术积累,公司已研发并商业化多代格兰菲自研硬件架构芯片,并同步构建起面向图形、计算与人工智能应用的格兰菲软件生态。
在外界看来,AI处理器与GPU似乎是两条不同赛道。但格兰菲方面认为,图形渲染、通用图形处理器和人工智能计算并非三条相互独立的技术路线,它们都建立在大规模并行处理、分层存储访问和可编程计算架构之上。底层技术同源,是格兰菲能够从图形走向通用计算,再走向端侧AI的基础。
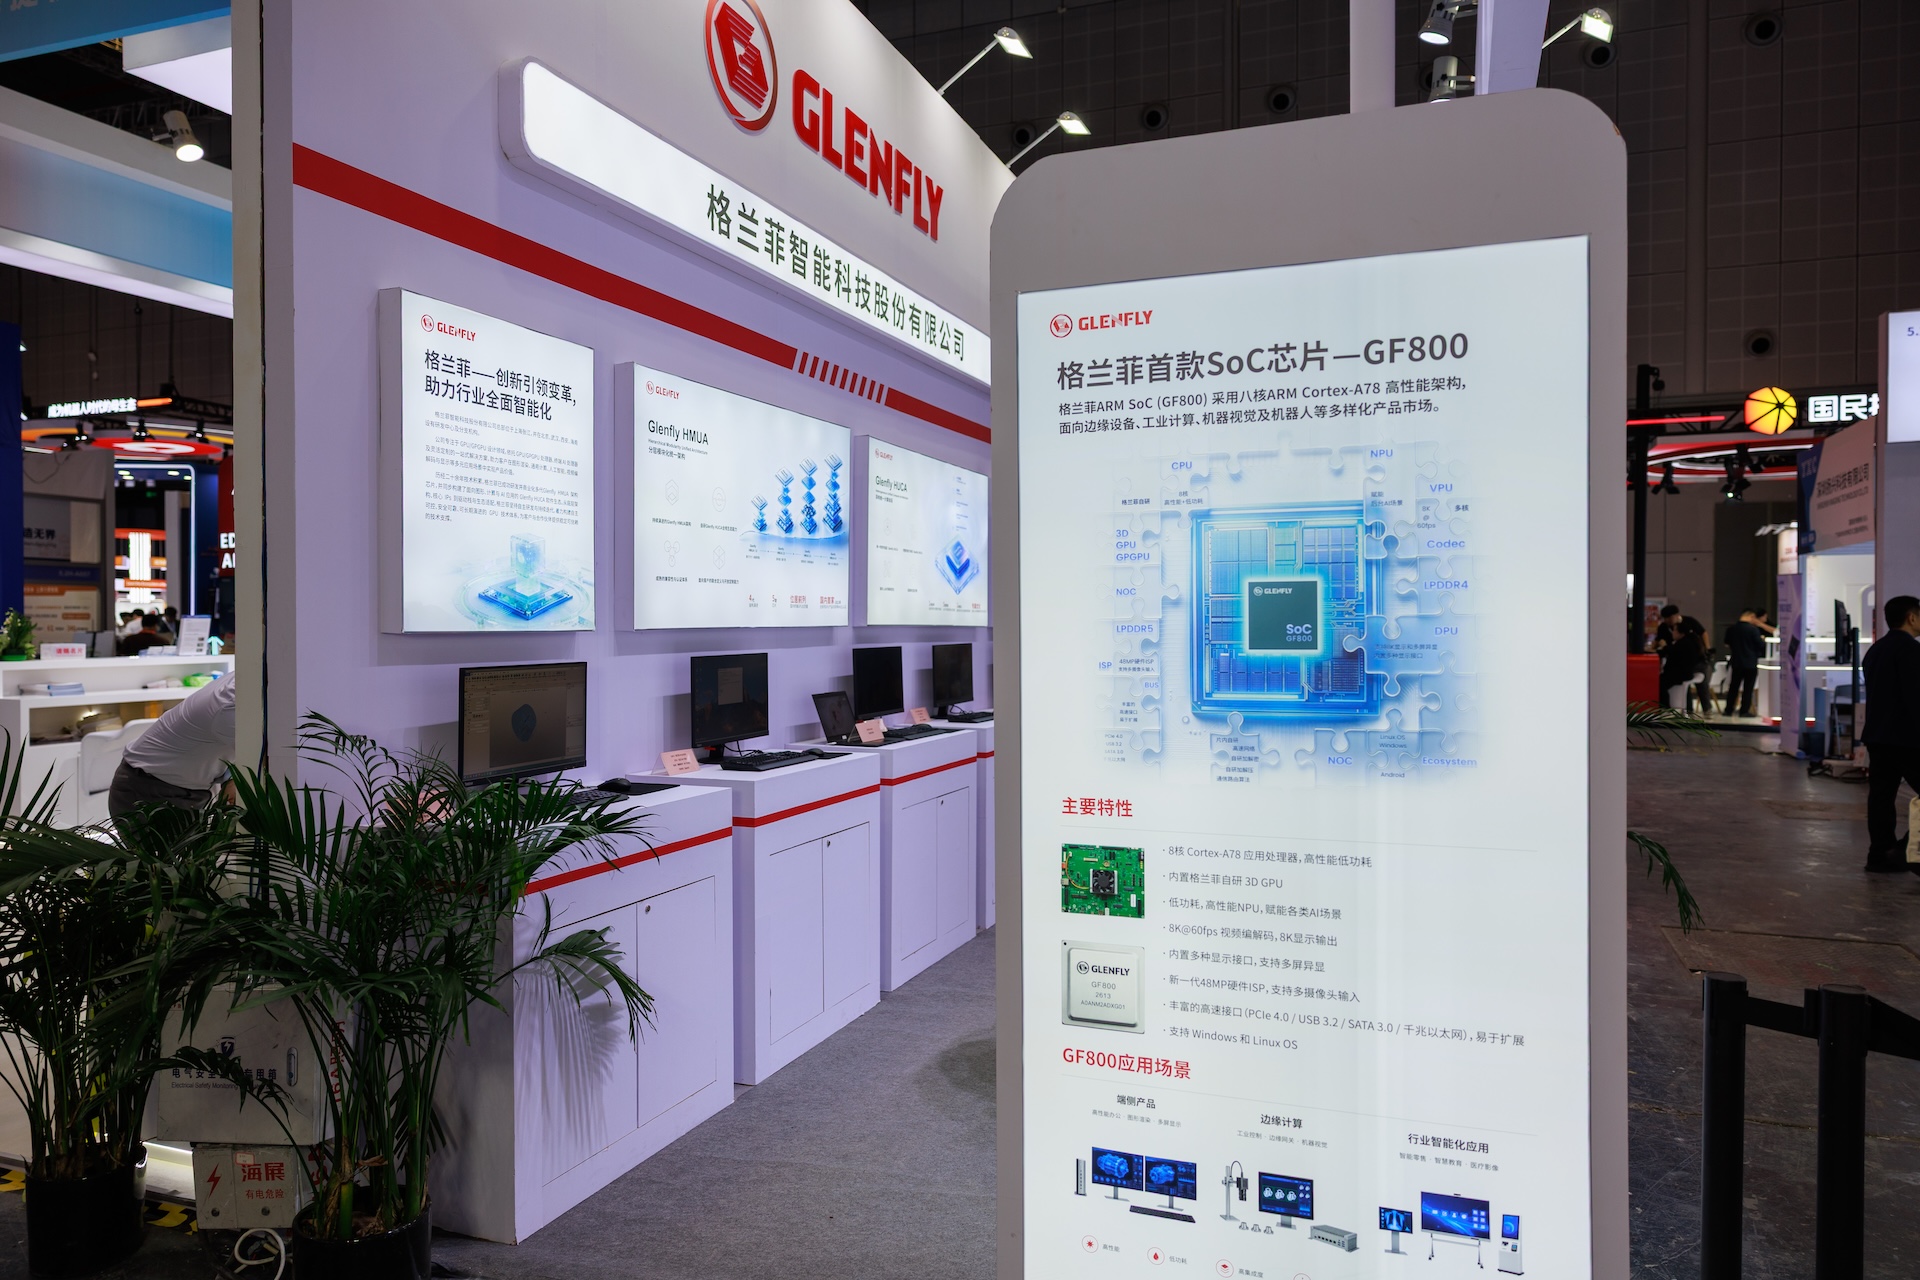
格兰菲工博会展台现场 (受访者供图)
硬件上,格兰菲通过自研硬件架构迭代,将图形处理器、通用图形处理器、矩阵计算、视频和显示等核心知识产权纳入统一的异构计算体系;软件上,格兰菲软件平台把驱动、编译器、运行时、加速库和模型部署工具衔接起来,使同一软件底座可以同时支撑图形、计算和人工智能应用。
当前,端侧AI需求正在从单点算力转向系统能力。中央处理器、图形处理器、神经网络处理器、内存、多媒体和软件生态需要协同,单靠一颗AI加速芯片很难解决实际问题。因此,格兰菲不仅提供图形处理器芯片和图形处理器知识产权核(IP),还进一步构建系统级平台能力,为客户提供可迁移、可定制的一站式解决方案。
武文杰表示,格兰菲并非从GPU“转行”做人工智能,而是将GPU从图形处理稳步发展为通用并行处理,再进一步发展为端侧异构人工智能计算平台。系统级芯片平台是三者实现系统级融合和规模化落地的产品载体。
目前国产GPU赛道参与者众多,武文杰将格兰菲的差异化概括为几个层面:架构上,依靠持续架构迭代优化功耗、性能、面积,减少对先进工艺和资源暴力堆叠的依赖;技术上,坚持自主GPU底层架构;产品上,做“图形+人工智能”融合的多模态计算;形态上,形成从图形处理器知识产权、独立图形处理器到系统级芯片平台的平台化产品体系;商业路径上,则依托既有规模化市场进入端侧人工智能。
在市场方向上,格兰菲重点看好智能终端、工业计算与机器视觉、边缘AI服务器、机器人与具身智能等领域。武文杰表示:“我们的目标不是简单把云端算力搬到终端,而是在实际功耗和成本约束下,让算力更接近数据、更接近设备,也更接近产业应用。”
让算力靠近设备 GF800搭载“图形+计算+人工智能”
此次工博会上,GF800是格兰菲展出的核心产品之一。据介绍,GF800采用“全大核中央处理器+自研图形处理器+专用神经网络处理器+统一内存”的组合架构,主要应对端侧AI智能体时代对多线程调度能力、异构协同效率和多模态数据处理的新需求。
武文杰告诉记者,全大核中央处理器更强调持续性能、多线程吞吐和高负载响应,适合人工智能体、代码编译、多任务办公、内容创作及工业边缘计算等负载。与过去一些终端芯片更强调低功耗轻负载不同,GF800的中央处理器设计明显面向更高强度的端侧计算。
GPU部分延续了格兰菲的自研路线。公司介绍,搭载自研GPU能更高效、快捷地支持本地大模型部署,并能够进一步为客户提供定制化多模态应用处理能力。统一内存架构则让中央处理器、图形处理器、神经网络处理器、视频处理单元之间高效协同,减少数据搬运带来的损耗。
在本届工博会上,机器人展品是一大热点,也与GF800的客户定位直接对应。武文杰认为,智能终端、边缘服务器、工业智能、机器人及具身智能等场景,与“图形+计算+人工智能”的技术路线高度契合。
据介绍,GF800目前已完成芯片调试,并已向终端客户送样,正围绕图形、显示、系统兼容性及行业场景开展适配和方案验证,为后续规模化应用奠定基础。王渊峰表示,这些行业的共同特点是,既需要图形处理和通用计算能力,又对端侧AI推理、实时响应和系统集成度提出更高要求。
国产GPU竞争将是生态和综合交付能力竞争
国内端侧AI算力市场需求正从概念验证走向实际落地。尤其在智能终端、工业智能、机器人和具身智能等领域,对大模型本地部署、低时延、数据安全和成本可控的需求持续提升。
王渊峰认为,端侧AI市场爆发的关键驱动因素在于大模型轻量化、端侧推理需求增长以及产业智能化升级;主要制约因素则包括软硬件生态成熟度、应用场景规模化落地进程,以及开发者生态和行业解决方案的完善程度。他判断:“未来竞争不仅是芯片性能竞争,更是平台能力和生态能力的竞争。”
在端侧本地大模型与云端大模型的关系上,格兰菲认为两者将长期共存、协同发展,而非简单替代。王渊峰解释,相比云端推理,端侧人工智能在数据安全、响应时延和长期部署成本方面更具优势,云端则在超大模型训练、复杂推理和资源弹性方面占据优势。企业客户尤其关注数据不出域、本地推理、低网络依赖和确定性时延,这也是端侧算力需求快速增长的重要原因。
软件栈与开发者生态长期被视作国产GPU的最大短板。“生态建设不是一朝一夕能够完成的,而是长期投入和持续协同的结果。”武文杰告诉记者,格兰菲从GPU研发初期就高度重视软件生态建设,基于自主GPU架构构建了格兰菲自研硬件架构和格兰菲软件平台,并持续推进主流操作系统、应用软件及人工智能框架的适配工作。
针对未来几年国内端侧图形处理器/通用图形处理器的国产替代节奏,武文杰判断将呈现两个方向:由政策及行业市场向开放市场延伸,由基础图形显示向“图形+通用计算+人工智能”升级。在此趋势下,格兰菲未来布局将以自主GPU架构为底座,逐步构建“图形处理器知识产权+图形处理器芯片+侧AI+系统级芯片计算平台+格兰菲软件平台”的产品体系。
“工博会是一个展示窗口,也是一次信号释放。格兰菲希望对外传递的,是长期坚持自主发展、持续迭代底层架构、完善软件生态,同时开放合作,连接芯片设计、整机制造、工业软件、算法模型和行业应用等上下游伙伴,推动国产GPU从单点替代走向协同创新和规模化应用。”王渊峰表示。
编辑:谈瑞
声明:新华财经(中国金融信息网)为新华社承建的国家金融信息平台。任何情况下,本平台所发布的信息均不构成投资建议。如有问题,请联系客服:400-6123115
















